不用机器人到场也能采数据:高德λ0让人戴设备走一遍,宇树G1就学会边走边搬
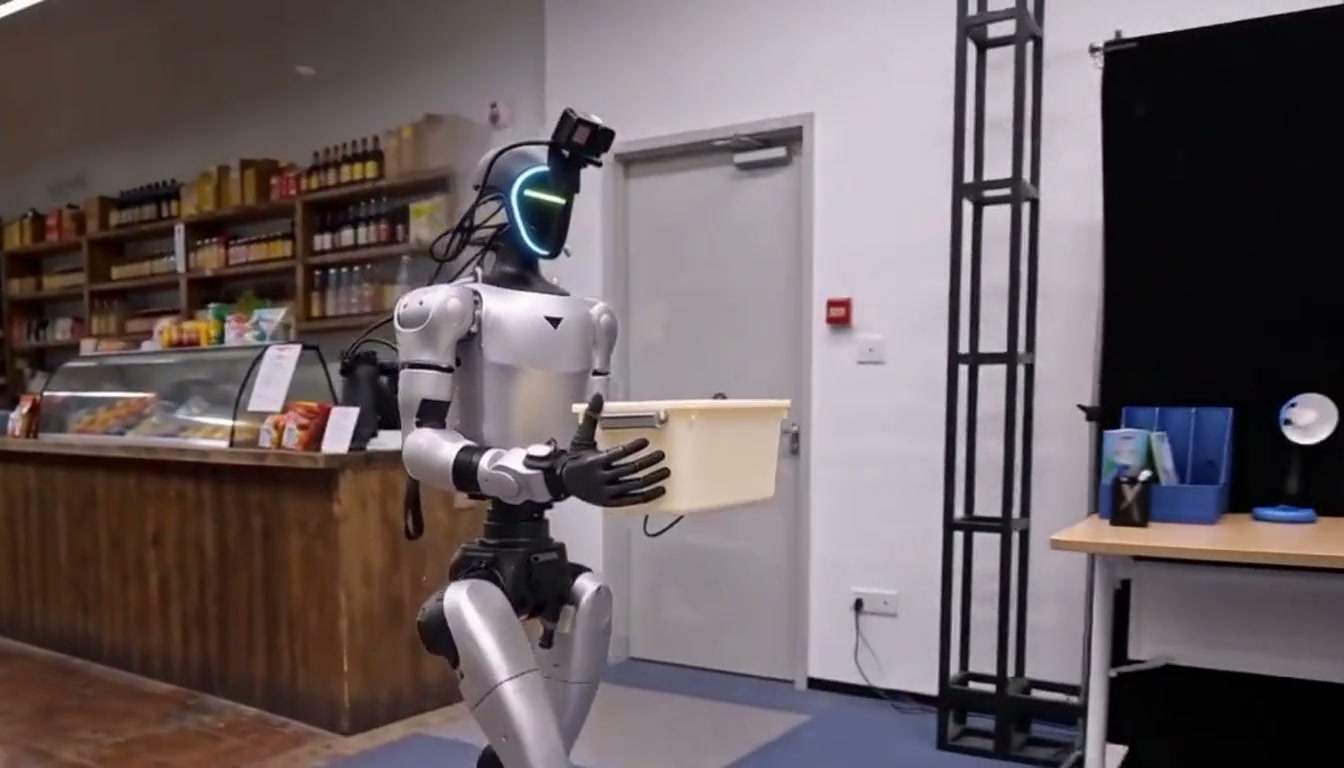
阿里巴巴旗下高德发布全身基座模型λ0:采集者佩戴消费级设备就能录下全身动作数据,单条示范采集从约100秒缩到29秒,真机任务成功率比最强对比基线高22.5%。
教人形机器人干活,通常要先让人遥控机器人把动作做一遍。高德换了个思路:人自己戴上设备去干,机器人照着学。阿里巴巴集团旗下高德发布全身基座模型λ0,只靠人类的行动数据,就让机器人学会移动、姿态和双手操作的全身协调。
高德称λ0是首个基于开放世界行为的全身基座模型,要解决的是“局部学习”的问题。以往第一视角的VLA(视觉-语言-动作)基座模型,数据大多只记录手和手臂的交互,缺少关节、躯干和位姿等全身信息;任务一旦需要边走边搬,这种碎片化的数据就不够用了。
λ0的做法是“无本体全身数据采集”:采集者只需佩戴消费级设备,在日常环境里随走随采,不需要机器人到场。代表性任务的单条示范采集用时由约100秒缩短到29秒,效率约为原来的3.4倍。项目页显示,真机验证用的是宇树G1,配BrainCo Revo 2灵巧手和头戴GoPro相机。
靠这条管线,高德建成了包含500小时开放世界无本体全身数据的HumanVerse-500数据集。训练分手部交互、全身协调、人形本体三个阶段,逐步把人的经验转成机器人的全身控制指令;针对人和机器人身材不同、末端执行有偏差的问题,λ0在采集、处理和动作端加了视角匹配和“由粗到细”的动作对齐。
成绩方面,λ0在SIMPLE仿真基准和多项真机评测中取得SOTA(当前最佳)表现,真机任务成功率比最强对比基线高22.5%。在7项全身协调与长程移动操作任务上,它只凭人类行动数据就在真机上实现了零样本迁移。
更关键的一条是数据规模的效果:机器人示范数量不变时,人类全身数据越多,真实机器人的任务表现越好。换句话说,往后可以多攒人的数据,少花钱让机器人陪练。
λ0由高德和阿里ATH事业群共同完成,相关硬件配置代码已在GitHub开源,HumanVerse数据样例已上线Hugging Face。高德称,这套方法为机器人在巡检、物流等开放场景学习全身协调任务打下基础。