说话前0.4秒先抬手:银河通用把人形机器人的"边说边比划"做成了实时生成
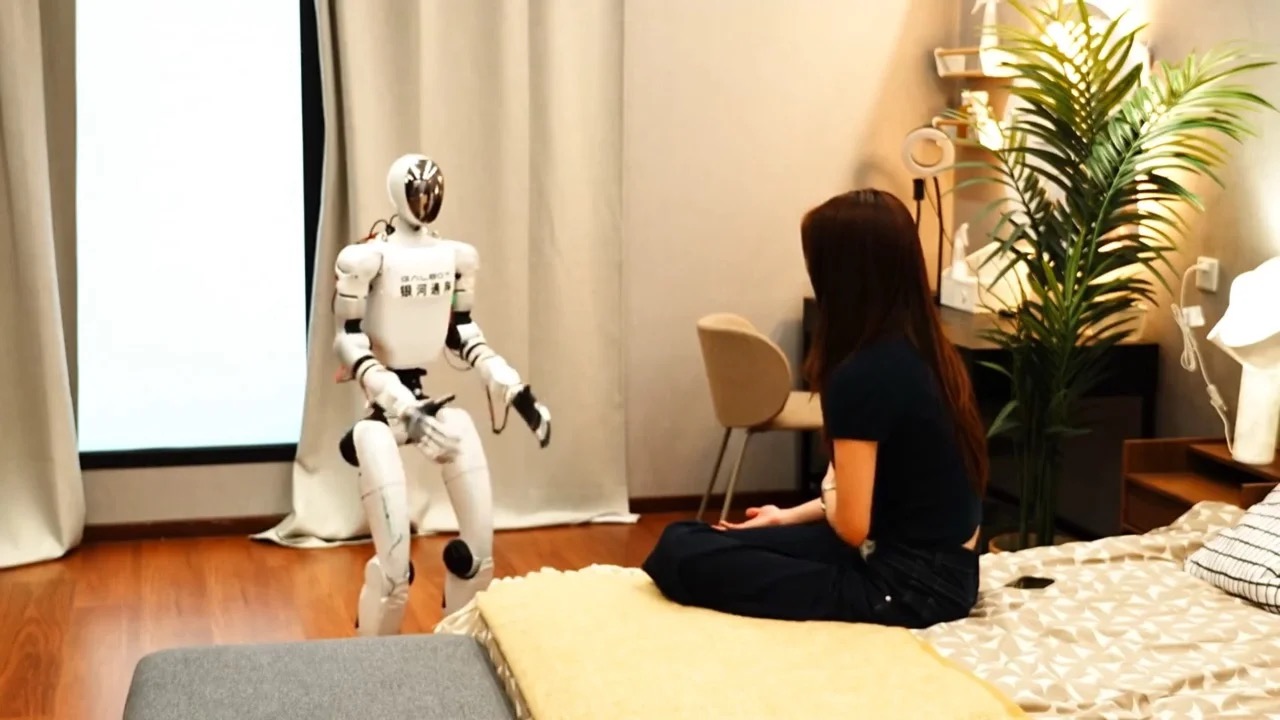 图:Humanoids Daily报道配图(RoboGesture项目演示画面)
银河通用联合清华大学、北京大学等机构发布RoboGesture,让人形机器人在对话中实时生成手势,将于9月10日在ECCV 2026上展示。它直接在机器人41个自由度的上半身空间里生成动作,帧率120FPS,并用模型预测控制安全滤波把自碰撞帧占比从4.16%压到0.13%。演示在宇树G1加BrainCo灵巧手上完成,200次真实试验零跌倒、零急停。
人形机器人现在会走会搬箱子,但一开口聊天就露馅:要么僵着不动,要么胳膊按固定节拍乱挥,跟嘴里说的话没关系。银河通用这次动的就是这块——让机器人边说话边比划,而且比划的内容对得上话。
据Humanoids Daily 9月6日报道,北京的银河通用(Galbot)联合清华大学、北京大学等学术机构发布了RoboGesture,一套端到端框架,用于实时合成自然、语义对齐且物理安全的伴随语音手势。该项目将于9月10日在ECCV 2026(欧洲计算机视觉大会)上展示。
技术路线上最关键的一步是"换空间"。以往做法是先在人体骨架空间生成手势,再通过逆运动学在线映射到机器人身上,结果常常是机械手拍到自己胸口的自碰撞,或者高频抖动。RoboGesture直接在机器人自己的关节空间里学,目标是41个自由度的上半身构型——躯干和双臂17个自由度,加上两只BrainCo灵巧手的24个自由度,绕开了推理时的重定向瓶颈。
针对流式生成中的"模态遮蔽"问题——模型图省事,靠历史动作的惯性往下续,把新进来的语音信号忽略掉——团队用了三层对策:一是分层语义-声学对齐器,用Mimi编解码器把原始流式音频切成token,浅层追节拍与起音、深层用一个300类手势分类器压出语义,因此机器人能在关键词说完之前就起手;二是反惯性CFG掩码,训练时以15%概率把历史动作上下文遮掉,逼模型"冷启动";三是延迟历史注入,把过去动作只喂给生成器的后段网络层。合成出的1秒动作块再过一道模型预测控制(MPC)安全滤波,按凸二次规划逐帧求解,把上半身自碰撞帧占比从4.16%降到0.13%。
数据和成绩都摆了出来。因为真实人形机器人数据稀缺,团队自建了半合成数据管线:用动作捕捉录制了300多类经核验的语义手势,再用大语言模型写脚本、语音合成配音,合成约1000小时经碰撞校验的机器人专用音频-动作配对数据;其中语义动作被刻意安排在对应关键词前约400毫秒启动,模仿人说话的节奏。在BEAT基准上,RoboGesture的Fréchet手势距离(FGD,越低越好)为0.8452,对比DiffSHEG的2.2316和Semantic Gesticulator的3.0147;仅在多样性一项低于Semantic Gesticulator,作者认为该指标会被抖动的不稳定动作抬高。演示部署在宇树G1人形机器人加BrainCo灵巧手上,200次真实部署试验中零跌倒、零急停。
剩下的瓶颈不在手上,在嘴上。银河通用宣称"听到-回应-比划"整个闭环约2秒,但按论文自己的分模块拆解,动作生成部分其实很快:连续DiT生成器有效吞吐120FPS,处理1秒动作块约需250毫秒,MPC滤波每帧仅5.6毫秒。真正耗时的是上游对话链路——语音识别确认说话人停顿约0.5秒、LoRA微调的Qwen模型起草回应约0.14秒、语音合成约0.41秒、音频token化约0.16秒。也就是说,机器人不是不会比划,是还在等自己想好该说什么。这件事的落点很实际:本站此前报道过银河通用在香港红磡、启德、湾仔开出三家人形机器人便利店,公司这周还开放了32公斤双足机型ET1的预订,主打门店迎宾、酒店服务和舞台表演——这些场景卖的就是人跟机器人面对面的观感,手势自然与否直接决定生意成不成立。