Figure花1500万美元众包1600万条训练视频
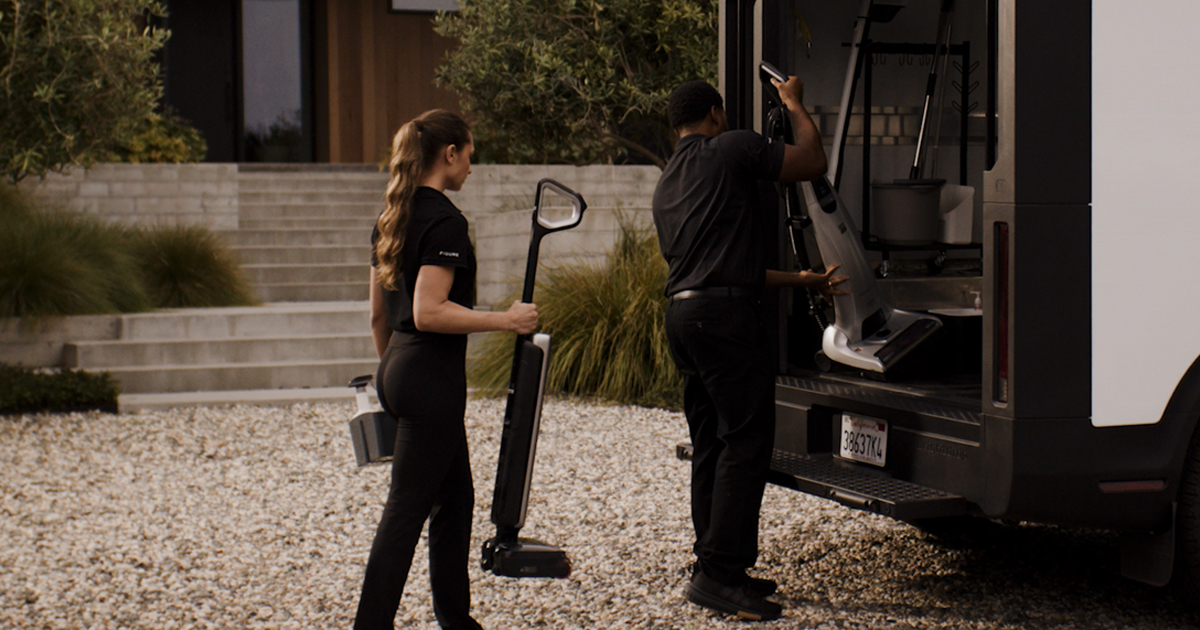 图:Figure AI官网Index发布页配图(Figure AI官方发布资料)
Figure AI推出众包数据平台Index。来自108个国家的创作者已上传超过1600万条第一人称视频,公司为此支付1500万美元报酬,并承诺未来12个月在数据与算力上投入超过10亿美元,用于训练自研的Helix模型。
机器人训练数据不够用,Figure AI给出的答案是:花钱请全世界的普通人,用手机把自己做家务的过程拍下来。8月25日,这家人形机器人公司结束隐身期,把此前代号Project Go-Big的项目正式命名为Index,并同步在App Store与Google Play上架。
Figure披露的隐身期成绩单为:4个月内应用下载量26.4万次,覆盖108个国家,周活跃贡献者超过4.4万人,累计上传视频超过1600万条。按官方说法,平台目前每秒钟就要处理30分钟的视频上传量,相当于每天有4.9年的人类工作时长被传上来。
数据的多样性被列为核心指标。Figure称,每采集1000小时素材,数据集中就包含373个不同任务、1146件被操作的物体和116个不同环境。采集内容从做饭、打扫、叠衣服、铺床等家务,延伸到物流中心、餐厅、工厂和办公室等商业场景,官方举的极端例子包括清理猫砂、换机油、收拾餐厅餐桌。
Index按双边平台运作:个人“创作者”可以录制自己完成日常任务的过程换取现金赏金,用户也可以通过应用预约创作者上门帮忙做家务,同时录下第一视角画面。截至目前,创作者累计已获得1500万美元报酬;Figure同时表示,未来12个月将在数据与算力上投入超过10亿美元。
为把消费级手机视频变成可训练的数据,Figure搭了一条五级流水线:自动过滤(分辨率、帧率、光照与任务相关性)、人工反欺诈审核、基于向量嵌入的去重、类别再平衡,以及分层标注,处理后的数据用于训练公司的Helix模型架构。创始人兼CEO Brett Adcock把Index定位为Helix实现零样本泛化所需的专用数据管道。
接下来更值得盯的不是上传量本身,而是这批数据究竟能带来多少可验证的能力增量:Helix在新环境、新物体上的成功率能提升多少,众包数据与机器人实机数据的配比如何,以及每10亿美元投入对应的任务泛化收益。