让人形机器人自己缩肩、弯腰、侧身挤过去:TANGO 全靠仿真数据练成
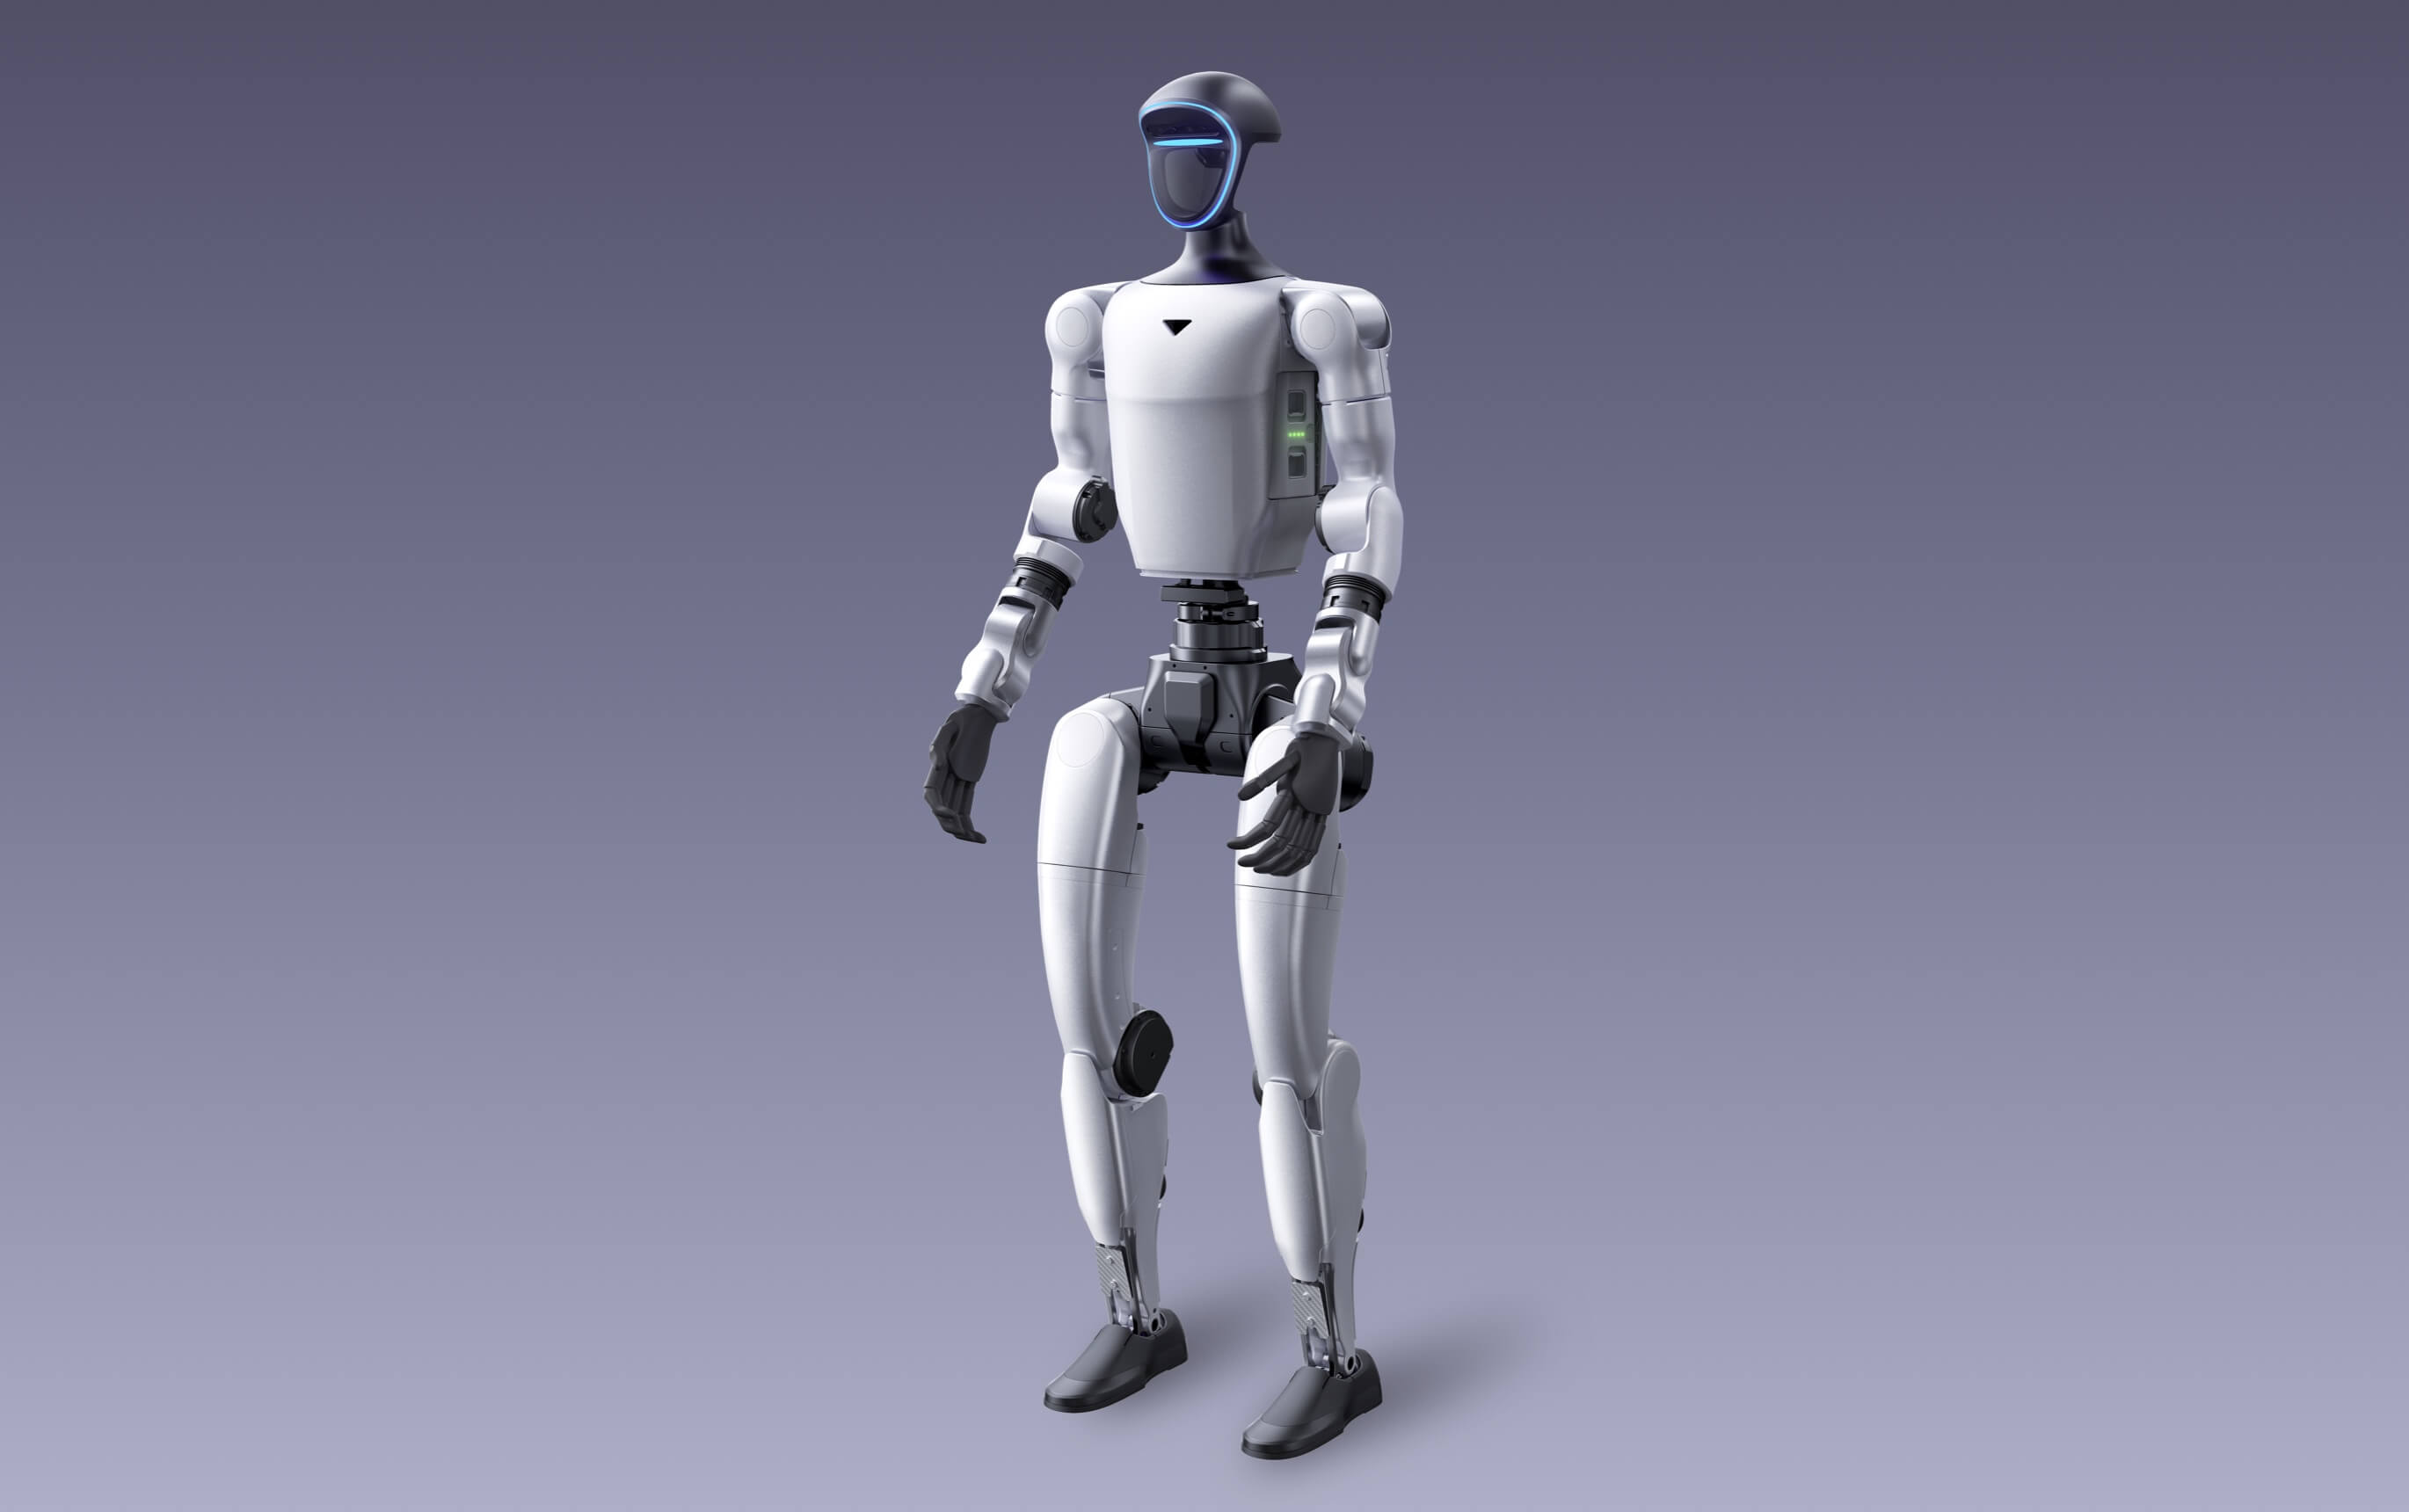
加州大学伯克利分校与普林斯顿大学的团队提出 TANGO,让人形机器人听一句自然语言指令、看第一人称画面,直接输出 29 个自由度的关节动作,自己决定收手臂、低头、跨过地上的东西还是侧身过窄缝。模型完全在仿真里训练,零样本迁移到宇树 G1 实机上跑通。
人形机器人在堆满杂物的屋子里走路,难点不在“往哪走”,而在“怎么让整个身子过去”。桌角、低矮的门梁、地上的箱子、两件家具之间的窄缝,每一个都要求机器人临时改姿势:手臂收一收、上半身侧一侧、步子迈大一点。
加州大学伯克利分校与普林斯顿大学的研究团队把这件事做成了一个模型,叫 TANGO。论文 9 月 8 日挂上 arXiv,作者为 Anqi Li、Yuxin Chen、Zhaobo Li、Zhuo Cao、Junli Ren、Masayoshi Tomizuka(伯克利)与 Dhruv Shah(普林斯顿)。
它和常规做法的区别写在论文第一段:传统方法把导航当成二维路径规划问题,在地图上画一条不撞墙的线;但人形机器人在杂乱环境里穿行,需要的是随时根据几何形状调整全身——手臂怎么放、躯干怎么摆、步态怎么变。TANGO 的输入是一句自然语言指令加第一人称 RGB 画面,输出直接就是 29 个自由度的关节空间动作。
训练数据全部来自仿真,靠一条自动流水线造出来:先做全局路径规划找出一条安全路线,再用运动学方法生成全身动作,接着做“避障动作编辑”——该收手臂就收手臂、该弯腰钻过去就弯腰、该侧身就侧身,最后把动作放进物理仿真器里重放一遍,撞到东西或者摔倒的样本直接丢掉。团队用这套流程生成了约 65000 条通过校验的机器人轨迹,代价是大约 211 个 GPU 小时的算力。
留下来的数据有一个关键性质:动力学上可行。也就是说这些动作不只是画面上看着能过去,而是真实的关节和力矩确实做得出来,可以直接拿来监督策略学习。
验证分两步。仿真里,TANGO 在视觉语言导航任务上取得了当时最好的成绩,在需要绕开障碍的复杂场景中也超过了分模块搭建的强基线方法。然后是实机:团队把模型零样本部署到宇树 G1 人形机器人上——没有用任何真实世界的导航数据做训练——在杂乱的真实场景里按语言指令稳定穿行。
把全身动作和语言指令绑在一起、又能不靠真机数据迁移过去,正是目前人形机器人进家庭、进办公室最卡的一段路。团队把论文和数据流程公开在 arXiv 上(编号 2609.09158)。